【開場】
凌晨,Google 又出手了。
距離上一代旗艦 Gemini 4 Argon 發布,僅僅過去了兩週。
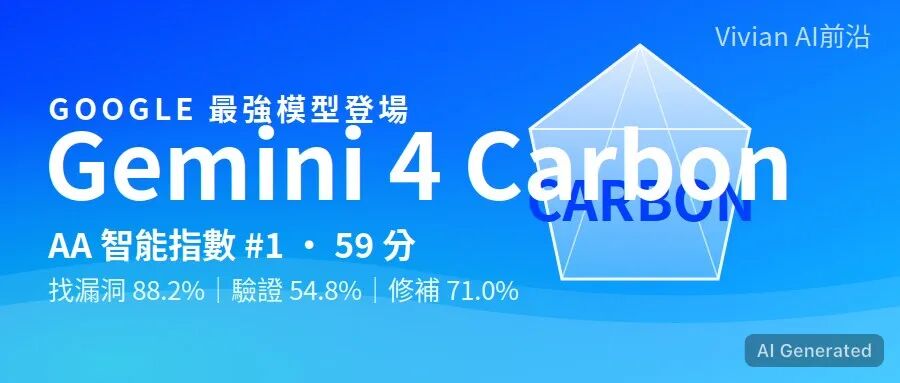
這一次,Google 直接端出了新一代前沿模型——Gemini 4 Carbon,以59 分登頂 Artificial Analysis 智能指數 v5.0,成為全球第一。
但真正讓整個矽谷坐不住的,不是這個 59 分。
而是它在網絡安全基準上的三項成績——找漏洞 88.2%、驗證利用 54.8%、修補漏洞 71.0%,三項全部刷新世界紀錄。
一句話總結:這是一臺專為網絡攻防打造的 AI 武器。
而 Google 只先開放給少數經過審查的網絡防禦者。
【一、59 分意味著什麼?】
先說清楚這個榜。
Artificial Analysis 智能指數,是目前業界公認最嚴格的第三方模型評測之一。v5.0 版本剛更新不久,全球所有頂尖模型都在這張榜上排隊。
Gemini 4 Carbon 拿下59 分,全球第一。
要知道,兩週前 Argon 登頂時的分數是 50 分。九分之差,在頂尖模型的競爭裡,是一個斷層式的差距。
作為對比,目前開源模型的天花板 Kimi K3.1 Pro 是 55 分,而 Anthropic 的 Claude Opus 5.5 也只有 58 分。
也就是說:Google 用兩週時間,把整個行業的天花板又抬高了。
【二、三項紀錄,覆蓋網絡防禦全流程】
真正硬核的在這裡。
網絡安全防禦,業界公認分三步:找漏洞 → 驗證風險 → 修補漏洞。Carbon 三步全部登頂:
第一步,找漏洞。
SEC-bench Pro 基準上,Carbon 拿下88.2%,能自主挖掘埋藏在真實軟件裡的複雜缺陷。對比 GPT-6 Astra 的 85.4%、上一代 Argon 的 83.4%,優勢明顯。
第二步,驗證風險。
找到漏洞只是開始,防禦者更想知道:這個漏洞到底能不能被利用?該優先修哪一個?
在 ExploitGym 基準上,Carbon 拿下54.8%——而 GPT-6 Astra 只有 42.4%,Argon 42.0%,Claude Opus 5.5 僅 34.5%。這一項的領先幅度,接近12 個百分點。
第三步,修補漏洞。
CWE-bench 上,Carbon 拿下71.0%,能把已驗證的漏洞直接轉化為可用的修補代碼,領先對手 3 至 4 個百分點。
一套 AI,把網絡防禦的完整生命週期打通了。
Google 內部還有一個更誇張的數字:Chrome 團隊報告,Carbon 生成高質素修補程式的能力,是另一家實驗室大型前沿模型的 10 倍以上。
【三、更可怕的是它的「安全感」】
做 AI 的都知道,模型越強,濫用風險越高。但 Carbon 這次的表現恰恰相反——
間接提示詞注入攻擊成功率:0.0%。
Gray Swan 基準測試中,攻擊者把惡意指令藏在模型讀取的內容裡,Carbon 的被攻破率是 0.0%,上一代 Argon 是 0.7%。
Terminal-Bench 4.0 作弊率:0.0%(嘗試率僅 0.4%),同時準確率不降反升。
內部編碼環境裡,高嚴重性對齊警報下降近 80%;過度服務下降 26%,服務不足下降 29%——翻譯成人話:它更願意「只做你叫它做的事」,不多做、不少做。
一個既能打、又聽話的模型。這才是防禦方真正想要的。
【四、為什麼只開放給少數人?】
這是最值得玩味的一步棋。
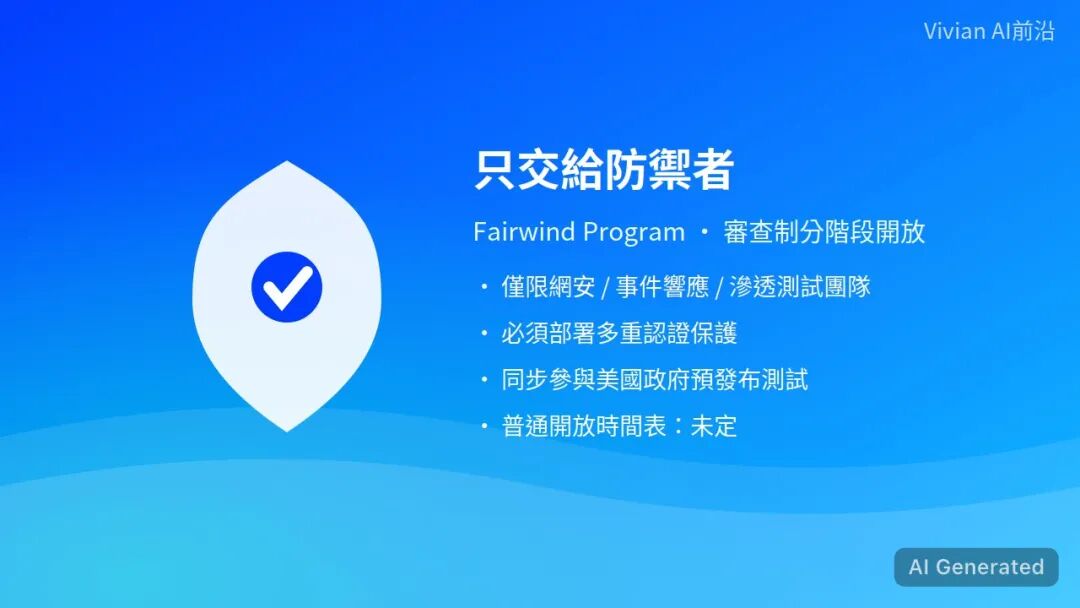
Carbon 本週開始只向部分網絡防禦者開放,之後通過Fairwind Program(Google 今年 9 月推出的安全機構審查計劃)逐步擴大。普通開發者、企業、消費者,暫時無緣,Google 連時間表都沒給。
為什麼?
因為這是典型的雙刃劍困境:同一個能力,能幫防禦者決定先修哪個漏洞,也能幫攻擊者決定先攻哪個目標。
所以 Fairwind 的參與者必須承諾:模型只用於內部網安、事件響應或滲透測試團隊,且必須部署多重認證等保護措施。Google 還同步參與了美國政府的自願性模型預發布測試。
新一代 AI 競備賽,已經從「誰的榜單分數高」,變成了「誰先把最強模型安全地交到防禦者手上」。
【五、價格與冷靜的一面】
價格方面,Carbon 延續 Argon 的首發優惠:輸入 2 美元、輸出 10 美元每百萬 token,緩存輸入再打 95 折。注意,試用期過後會漲到 4 美元和 20 美元。
當然,也要潑一盆冷水。
Google 自己承認:這些外部網安成績是在無安全護欄的條件下測出來的,用戶實際拿到的版本會有防護層,成績可能打折扣。獨立機構 Artificial Analysis 也指出,Carbon 的幻覺率從 Argon 的 4% 升到了 11%——更強,但也更敢說。
此外,三項紀錄中目前只有 CWE-bench 一項獲得獨立復核,其餘兩項仍是 Google 自測。
前沿模型的每一次躍遷,興奮之餘,都得留半隻眼睛看證據。
【結尾】
兩週一代旗艦,網安基準三項登頂,卻只交給審查過的防禦者。
AI 競備的上半場比的是誰更聰明,下半場比的是誰更可靠。
這一次,AI 第一次站在了防守的一方。
更多當日 AI 前沿,請關注視頻號 👉 [VivianAI前沿]
資料來源:Google 官方公告、Artificial Analysis、Vector News、The Neuron、BW Businessworld(2026 年 10 月 28-30 日報導)